这份报告是怎么来的
过去三天,我把 Jev 接进了自己每天在跑的工作流,跑了四组实验,采样上千次真实调用。下面出现的每一个数字,都是在这台机器上跑出来的,不是转述发布会。
值得单独写一篇的原因是,中文圈目前关于 Jev 的稿子基本都在重复同一组数字:快 200 倍,便宜 400 倍。这组数字来自厂商基准测试,本身没有造假,但它的算法是拿最贵的对手比最便宜的场景。真把它放进一个具体工作流,结论会变。
还有一个原因。官方有一篇 cookbook 的实验对象就是我们正在用的这套 agent 框架,182 个技能全部作为样本。中文圈大概没有人意识到自己被测过。这件事放在后面讲。
先看关键数字
如果你只有一分钟,这七条是全文的骨架。每一条在正文里都能找到算法和原始数据。
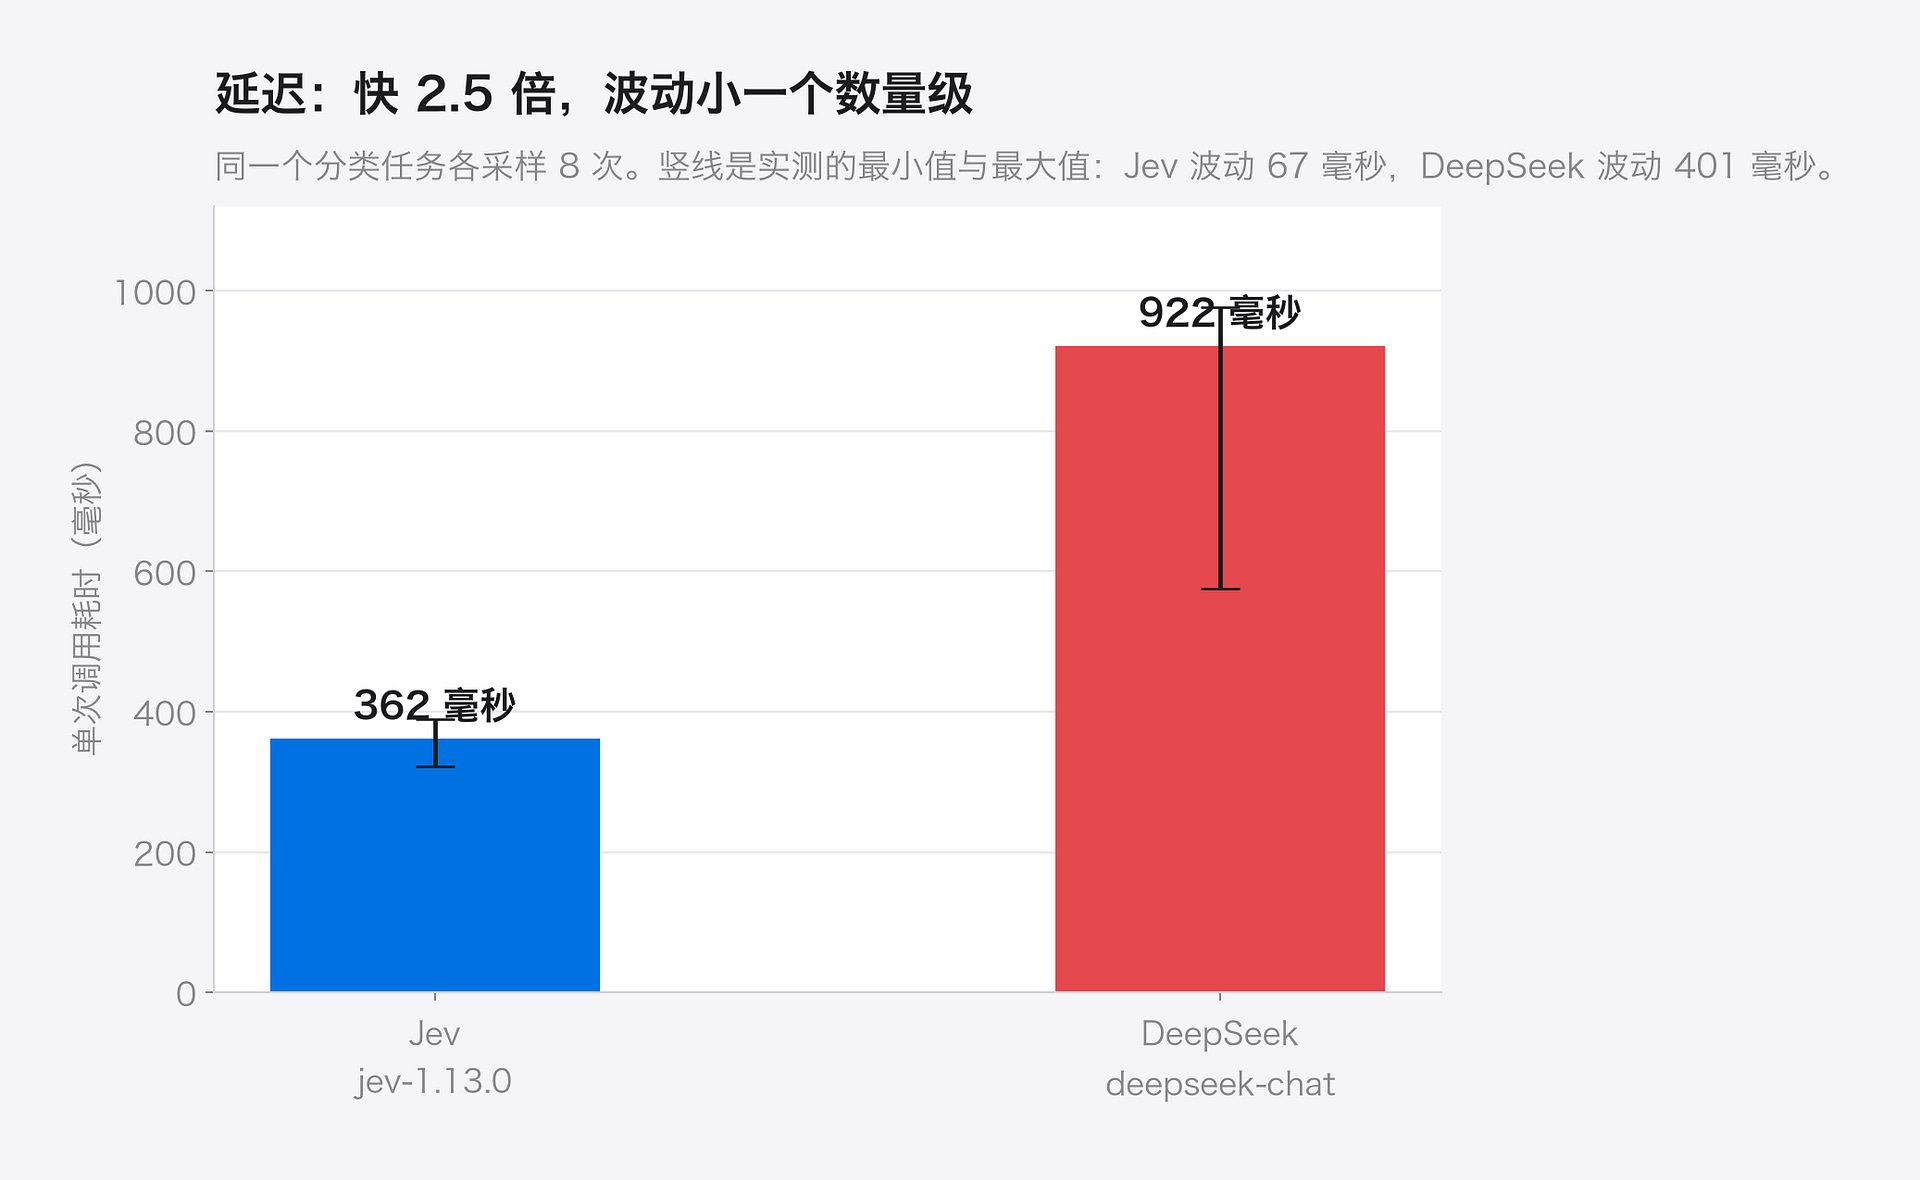
- 延迟 362 毫秒对 922 毫秒,Jev 快 2.5 倍,而且波动只有对方的六分之一。
- 成本 0.0000255 美元对 0.0000451 美元,Jev 只便宜 1.8 倍。厂商说的 400 倍,在我们的场景里不存在。
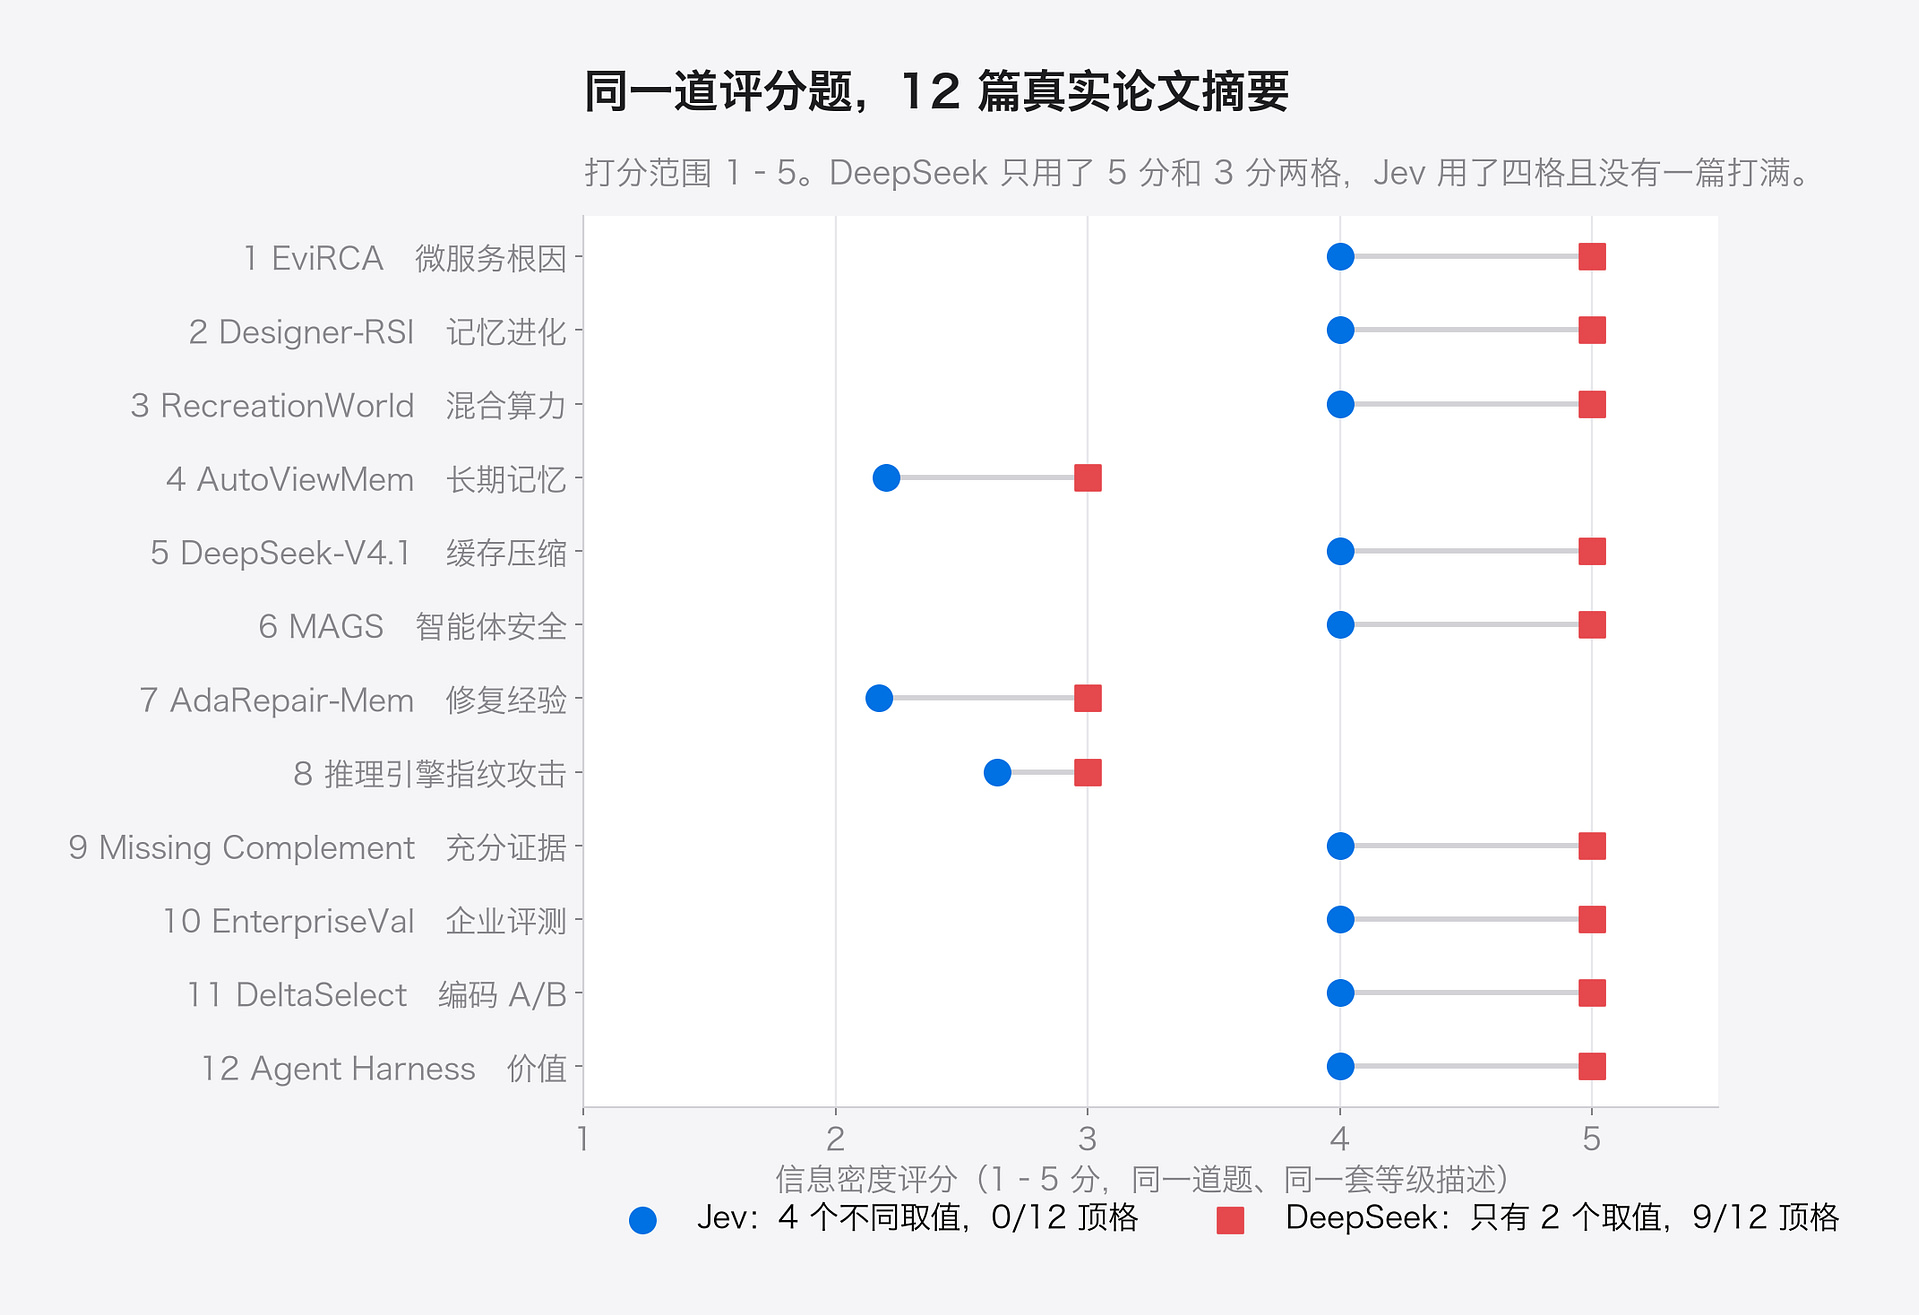
- 同一道评分题,DeepSeek 只给出两个取值(5 分和 3 分),12 篇里 9 篇直接打满。Jev 给出四个取值,一篇都没打满。
- 过滤不是无条件省钱。论文筛选净亏 17%,会话上下文压缩净省 54%,差别来自内容本身有多可丢。
- 回本线大约在压缩率七成。下游换成一个每百万 2 美元的前沿模型,同样的配置立刻省 71%。
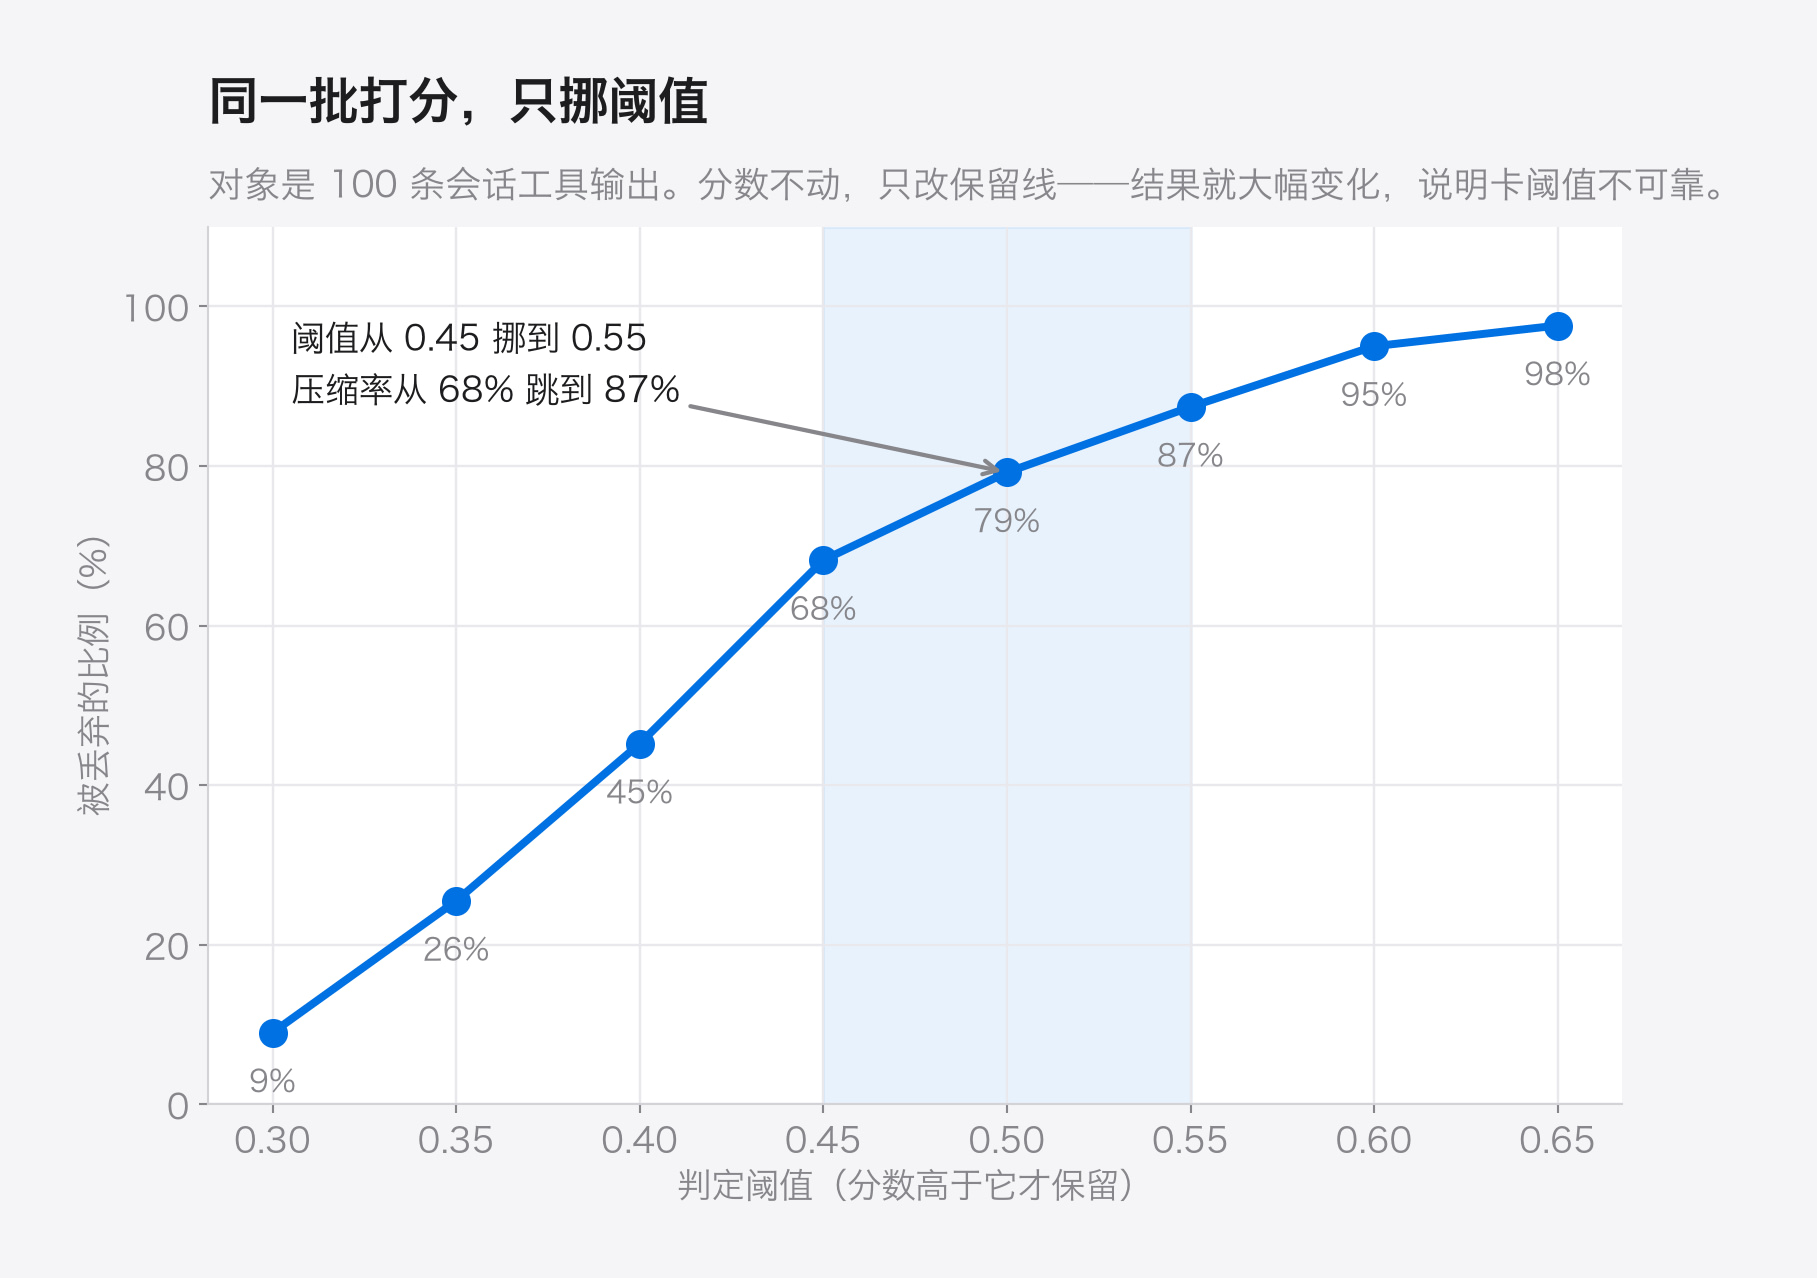
- 阈值不可靠。同一批分数只挪阈值,压缩率从 68% 跳到 87%。正确做法是排序取前若干条。
- 官方那篇技能实验的样本就是 Hermes 的 182 个技能。加上 Jev 的建议,加载错误技能的比例从 16.8% 降到 7.3%。
它到底是什么
Jev 不写文章,不回问题,不做客服。你给它一段材料加一道题,它给你一个可以排序、可以卡线的概率。
官方给了三种问题形状。Noul 问「是不是」,回一个 0 到 1 的概率。Choice 问「选哪个」,回选中的那项加上每个选项的概率分布。Score 问「在哪个等级」,回一个加权分和每档的概率。一次调用可以同时问一堆问题,我实测过 12 个问题一次返回,延迟几乎没有变化。
它和普通大模型的分工是这样的。大模型是「你给它一段话,它给你一段话」。Jev 是「你给它材料,它给你一个数」。写代码的人负责流程,它负责流程里那些需要语感的判断。
延迟和成本:那些流传的数字
先说延迟。同一个分类任务,Jev 的中位耗时是 362 毫秒,最小 322,最大 389。DeepSeek 的中位是 922 毫秒,最小 576,最大 977。
快 2.5 倍。这个结论没问题。
更有意思的是波动幅度。Jev 的八次采样全部落在 67 毫秒的区间内,DeepSeek 的区间是 401 毫秒。对线上服务来说,稳定的 350 毫秒通常比平均值 900 毫秒、偶尔 600 毫秒更好用,因为超时阈值好设。
再说成本,这里的分歧就大了。
同一个任务,Jev 消耗 607 个输入 token,按官方每百万 0.042 美元算,单次成本 0.0000255 美元,输出不计费。DeepSeek 消耗 272 个输入加 25 个输出,按 V4-Flash 的价目表算,单次 0.0000451 美元。
便宜 1.8 倍。厂商说的 400 倍,在我的场景里是 1.8 倍。
差距来自两个地方。Jev 的输入 token 反而更多,因为每个问题的定义都要占位。下游的 DeepSeek 本身已经极便宜。
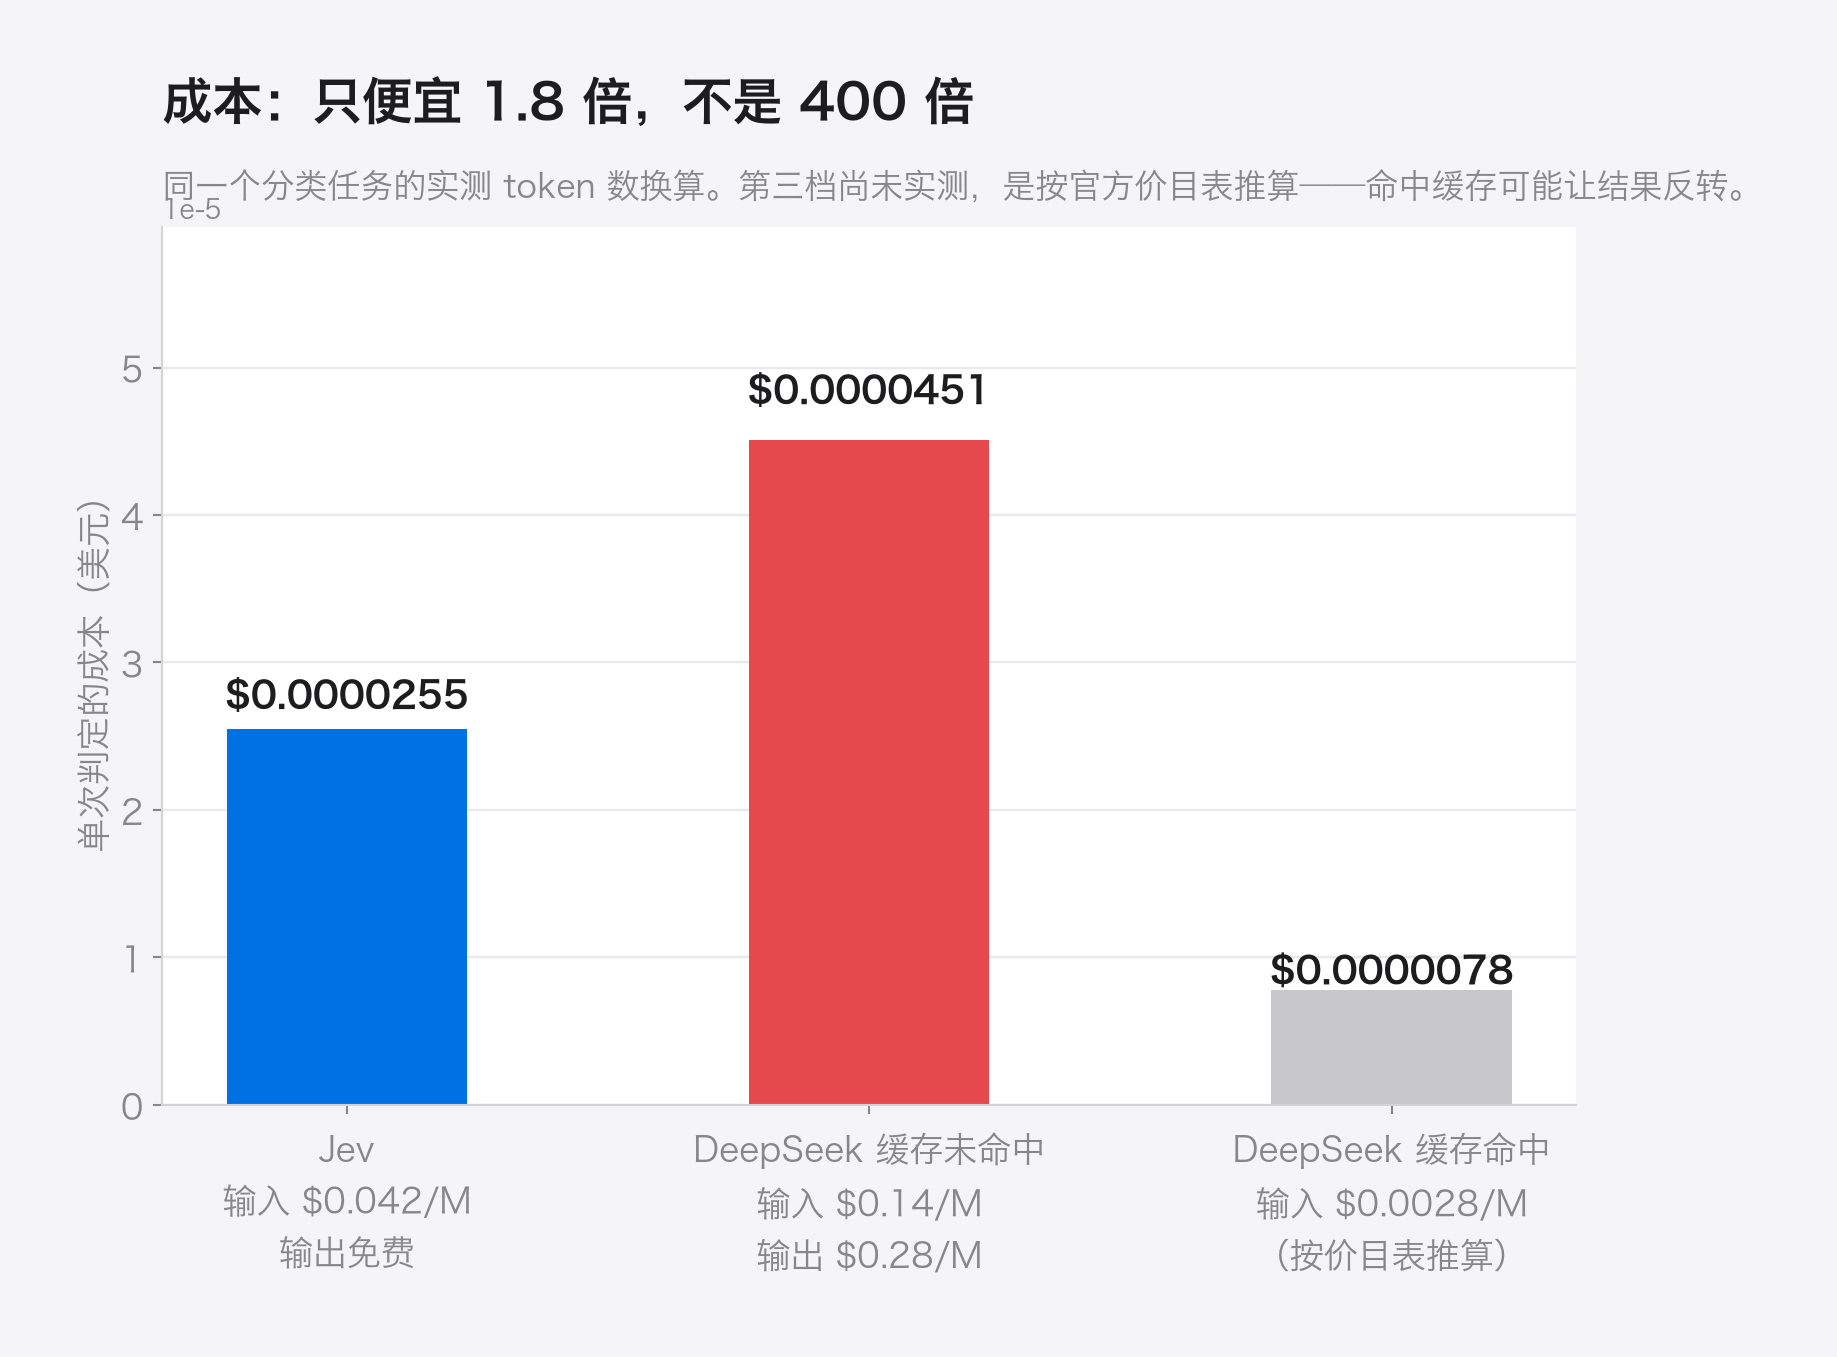
第三档值得单独说。DeepSeek 的缓存命中价是每百万 0.0028 美元,比未命中便宜五十倍。我的判定任务里,问题定义永远不变,变的只有被判定那段材料。如果前缀能稳定命中缓存,单次成本会掉到 0.0000078 美元左右,反过来比 Jev 便宜三倍。
这一档是按价目表推算的,我还没实测。文章里标出来,是因为它足以推翻「Jev 一定更便宜」这句话。
真正的差别在分辨率
上面那些都是钱和速度。真正让我改变判断的,是下面这个实验。
我取了 12 篇真实的 arXiv 论文摘要,写了一道 1 到 5 分的题,问信息密度。同一道题、同一套等级描述,分别交给 Jev 和 DeepSeek。
结果是这样。DeepSeek 给出的 12 个分数里,只有两个不同的值:5 分和 3 分。9 篇打了满分,75% 直接撞到天花板。Jev 给出了四个不同的值,从 2.17 到 4.00,没有一篇顶格。
DeepSeek 并不是瞎给分,它把三篇质量偏水的摘要挑出来了,那三篇 Jev 也判低。问题在于它的量程只用了两格。剩下九篇全挤在满分上,你想按分数排序,排出来的结果没有信息。
这是大模型在打分任务上的通病。它的训练目标是「给出一个像人写的回答」,不是「把一批东西排出顺序」。任务本身要求结果可比较的时候,生成式模型会把答案收敛到众数上,因为那样最安全。
Jev 也不是完美的排序器。它把九篇都给了 4.00,粒度同样偏粗。但它至少在好和坏之间有界线,而大模型那条线根本不存在。
这一条比速度和成本都重要。它解释了为什么要把判断从大模型里拆出来:拆出来的东西是分辨率。
图里那 12 篇是什么
上面的图用了论文短名,完整的标题和原文链接在这里。编号与图中纵轴一致。
| 编号 | 论文 | 原文 |
|---|---|---|
| 1 | EviRCA:微服务根因分析中的证据抽取与推理解耦 | arXiv:2609.19825 |
| 2 | Designer-RSI:从用户流量中演化程序性记忆 | arXiv:2609.22086 |
| 3 | RecreationWorld:面向混合算力的可验证环境 | arXiv:2609.22000 |
| 4 | AutoViewMem:对话长期记忆的自配置正交视图 | arXiv:2609.21940 |
| 5 | DeepSeek-V4.1-Flash:把 KV cache 压缩推到极限 | arXiv:2609.19969 |
| 6 | MAGS:多智能体自动形式化保障输出安全 | arXiv:2609.19391 |
| 7 | AdaRepair-Mem:仓库级程序的适应性经验编排 | arXiv:2609.20130 |
| 8 | 推理引擎指纹攻击的实用性研究 | arXiv:2609.20614 |
| 9 | The Missing Complement:状态条件下的最小充分证据 | arXiv:2609.20050 |
| 10 | EnterpriseVal:量化生成式系统的效力、可靠性与价值 | arXiv:2609.21841 |
| 11 | DeltaSelect:面向编码智能体的低成本 A/B 测试 | arXiv:2609.19607 |
| 12 | Agent Harness 如何创造价值:规划信息与发布控制 | arXiv:2609.20474 |
顺带说一句,第 5 篇就是讲 KV cache 压缩的,我后面拿它做了另一个实验。那篇的全文有 25475 个词。
它会跟着内容走
为了排除「Jev 只是输出恒定值」的可能,我做了个对照:同一篇论文,先用完整摘要做材料,再用一句话的缩写做材料。
完整摘要的信息密度判 3.61。压成一句话之后掉到 1.38,同时置信度从 0.67 降到 0.48。评分跟着内容走。
稳定性我也单独测了。5 篇摘要,同一个问题重复问 8 次,Jev 每题概率的平均标准差是 0.0033。官方公布的同类实验数字是 0.0102。我们场景下更稳,而且是独立跑出来的。
这里要诚实地标一个测量缺陷。DeepSeek 那一侧我做了二值化处理,而它在重复采样里每次都回答同一个值,于是二值化之后标准差恒为零。这个零是测量假象,不能写成「DeepSeek 更稳定」。可说的只是:恒定输出既没有方差,也没有信息。
便宜不代表划算
知道怎么用之后,我拿它做了两件真事。
第一件是筛论文。我把那篇 25475 词论文的全文切成 72 块,让它挑出与某个具体问题相关的段落。第一版判据我写成了一句话塞进四个条件,结果 72 块全部被丢掉,连明显相关的机制段落都没留下。改成一个问题只问一件事之后,压缩率回到 57.5%。
但这一版是亏钱的。压缩 57.5% 省下的钱,抵不过打分本身的开销,净亏 17.4%。
第二件是压缩对话上下文。我从自己的会话库里取了 100 条最大的工具输出,合计 55 万 token。这一版压缩率 79.2%,净省 54.1%。
同一个模型、同一个下游,两次结果一正一负,差别来自内容本身可丢弃的程度。工具输出比论文正文可丢得多。
把两件事放在一起,能算出一条线:在下游是 DeepSeek 这种价位时,压缩率要到七成以上,过滤才开始赚钱。如果下游换成每百万 2 美元的前沿模型,同样的配置立刻省 71%。
所以 Jev 过滤的价值不取决于它自己,取决于下游有多贵。
我踩过的坑,官方附录里都写着
上面那些失败让我回头去翻文档,结果发现官方的 sde_cascade 附录里有一节叫「什么才是好的验证器信号」,五条标准。我几乎每一条都反着做了一遍。
第一条是「窄而落地」。判据要针对一个字段、一个可核对的是非题。官方原话是,含糊的问题给出含糊且未校准的分数。我那个塞了四个条件的判据就是活教材。
第二条是「坏等于真,并且写明真假」。我把这条改对之后,之前那个误判修好了。同一段作者名单,宽松的长句判据给 0.98,误判成需要保留;写成明确的真假定义之后给 0.01。
这条也埋着一个后门。我一开始把「真」的定义写成「有具体倍数、百分比、或带数值的基准分数」,那半句「带数值的基准分数」让作者名单又拿到了 0.93。收紧成「出现了压缩相关的具体数值」之后才回到 0.02。真和假两侧都得写成可核对的具体条件,不能留模糊子句。
第三条是「逐项打标再取最大」。我多判据合并时用了取最大值,跟官方一致。
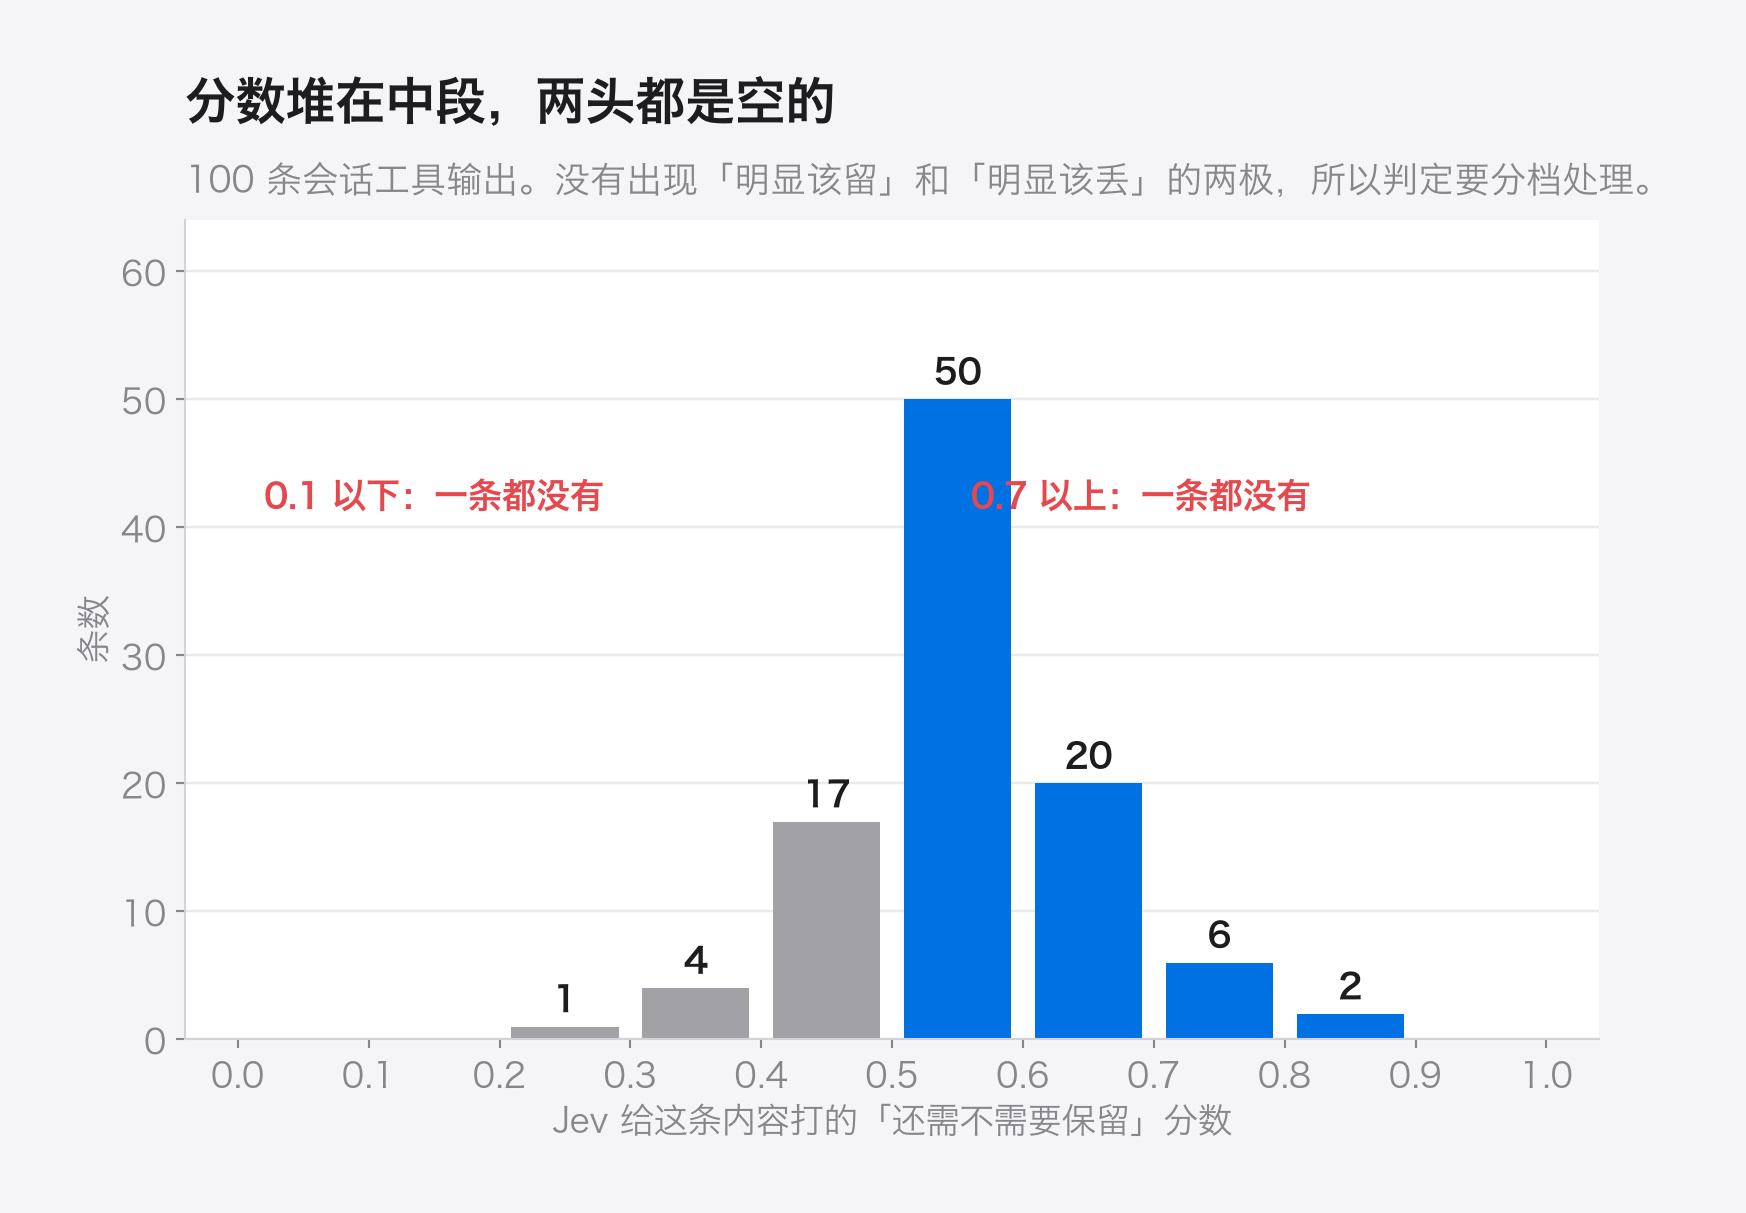
第四条和第五条要求这个东西独立、便宜,还得能把好坏分开。这一条我原本以为没做到。我的打分分布堆在中段,0.7 以上一条都没有,0.1 以下也没有。我当时的判断是「信号不够好」。
后来才知道这个判断也错了。正确读法是:那不是信号不好,那是「该降级」的那一半。这条放在后面讲。
顺序取前 k、不卡阈值,也是官方推荐做法。我一开始把「阈值挪 0.1 压缩率跳 19 个百分点」当成自己的发现,翻文档才发现 rerank 那篇 cookbook 原文写的就是用概率本身排序、不要阈值。
置信度是降级开关
官方的分类 cookbook 里有一组数字,解决了我上面那个「信号没分开」的问题。
他们拿 60 份 SEC 年报做行业分类,一个问题给 75 个候选。按置信度 0.9 切一刀,正好切成两半。有信心的那一半准确率 90%,另一半只有 40%。
接下来这一步才是重点。他们不丢弃那 40%,而是把它往上报一级,报更粗的门类而不是具体的行业组。准确率从 40% 变成 70%,而且不花任何额外调用,因为标签本身是层级的。
这给了我一个现成的修正方案。我原本在纠结「这条上下文到底该丢还是该留」,正确的做法是设计三档动作:置信度高的逐字保留,中等的压成摘要保留,只有低的才丢弃。
打分没有分辨率的时候,解法是降低判断的粒度,不是硬把一个连续的分数切出好坏。
官方拿我们自己的技能库做了实验
现在说开头那件让我意外的事。
官方有一篇 cookbook 叫 skill suggestion,实验对象是 Nous Research 的 Hermes 技能库,182 个技能全部作为样本。文档原文写着一句话:Hermes 默认把技能描述截断到 60 个字符。
他们描述的症状很具体。在 60 字符的宽度下,「编辑 pptx 的技能」和「创作 pptx 的技能」读起来几乎一样。用户要一份路演稿,agent 可能加载错的那一个。如果这一轮根本不需要技能,它也可能硬加载一个,因为一串名字本身就引诱人去猜。
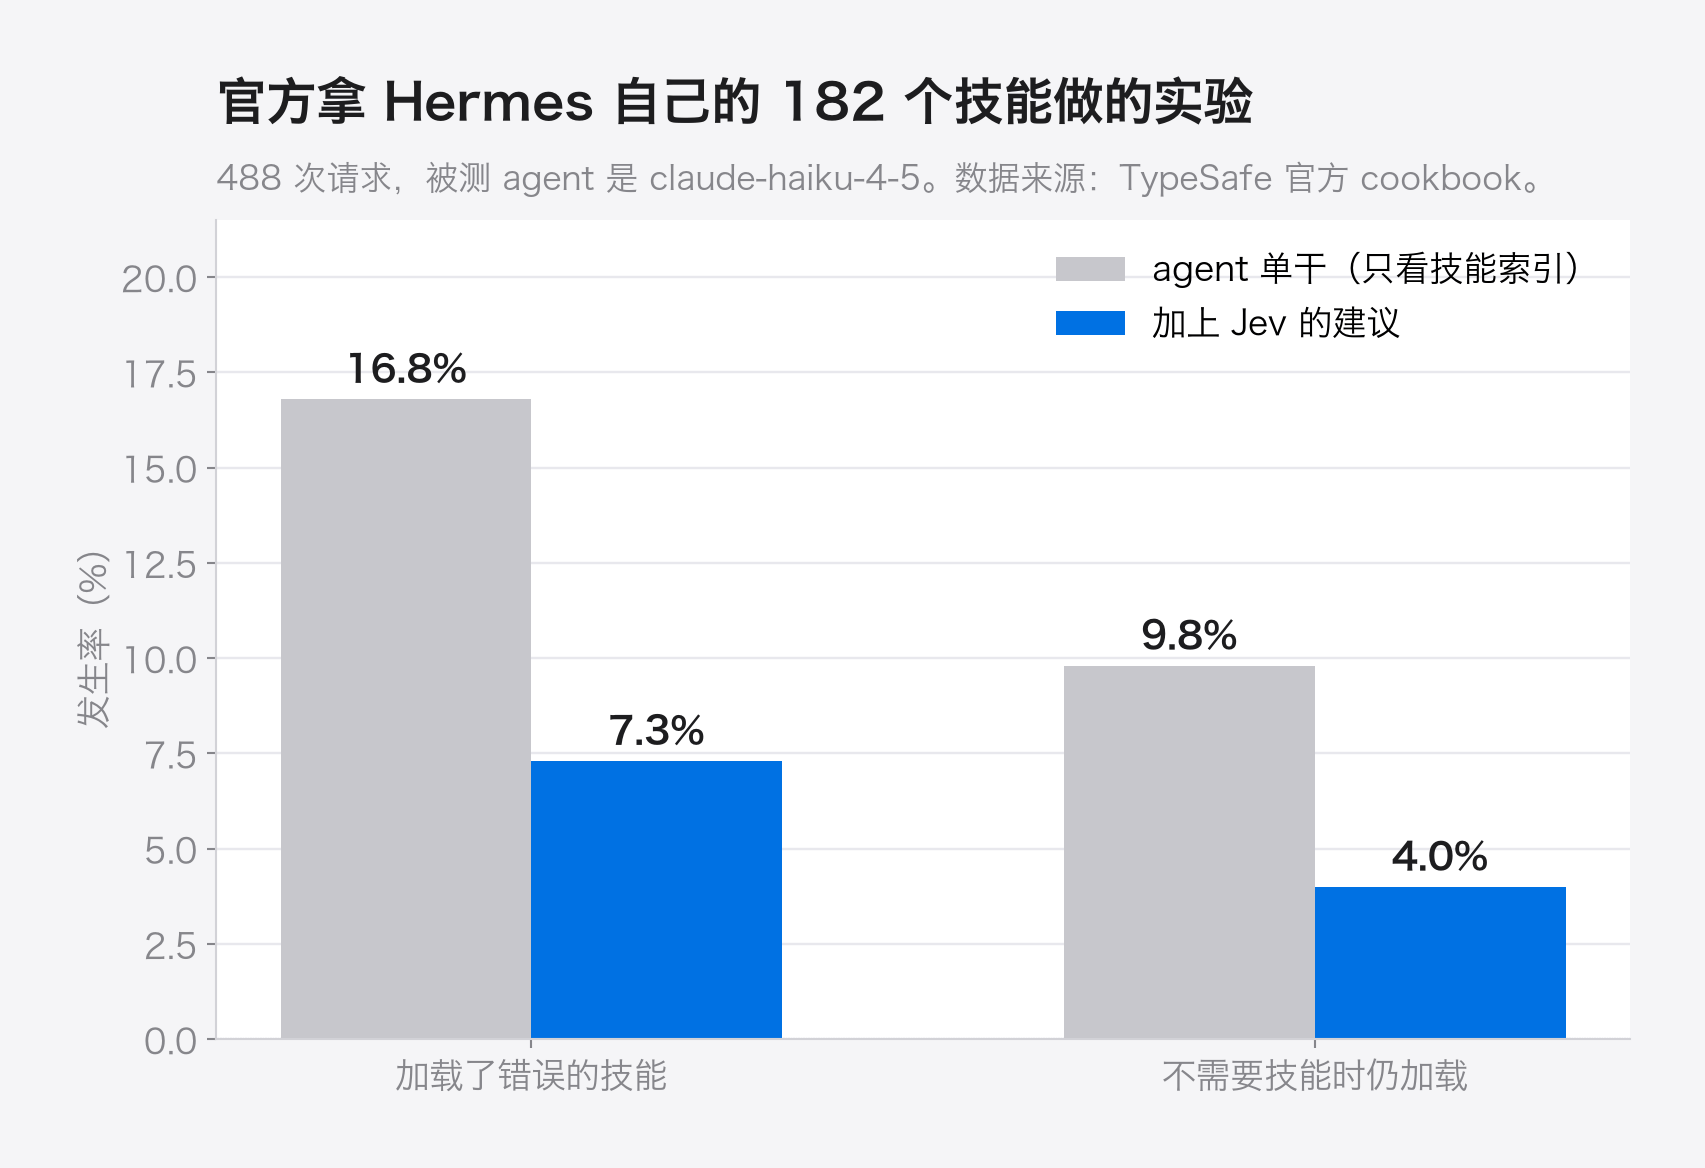
他们的方案是两次请求。第一次用一个 Choice 扫全部 182 个技能,同时用几个 Noul 判断这一轮到底需不需要技能。第二次只细读前三名,带上完整描述和正文开头,允许全部否决。胜者的名字写进系统提示的一行。
结果是错误加载率从 16.8% 降到 7.3%,不需要技能时硬加载的比例从 9.8% 降到 4.0%。表格里还有第三行:直接把正确答案给 agent,错误率是 2.5% 和 1.2%。也就是说错误率的地板不是零,给了对的技能它也不是每次都加载。
写这篇文章的时候,我正在给自己建这个 Jev 技能。工具的报错原话是,新技能的描述必须塞进 60 字符的系统提示预算。我被迫把描述砍到 47 个字符。
那条上限被写进了他们的评测,而我恰好撞在上面。
它做不到什么
它不能写作,不能总结,不能对话。所有需要产出一段文字的场景都不适用。
它不能部署在自己的机器上。没有开源权重,没有自托管方案,只有官方 API。硬件配置这件事跟它无关。
英文是它的主要训练语言。官方说明里写着,包括中日韩文字在内的其他语言可以处理,但表现不平等。我实测了 20 组中英同义配对,中文平均分比英文低 0.042,方向一致的有 13 组,但真正被压到判定线以下的只有 1 组。
这里要交代我自己的一个错误。我最早只做了 5 组,看到中文 0.83 对英文 0.96,就下结论说中文会被系统性压低、会显著增加误判。扩到 20 组之后落差缩到 0.042。小样本撑不起「系统性」这三个字。
它给的是概率,不是答案。官方文档把这条写得很直白:类型化的输出保证的是接口,不是真相。真相还得在自己的领域里验证。
还有一个容易搞混的地方。Noul 没有置信度字段,它返回的那个数就是「是」的概率。Score 和 Choice 才有置信度,而且那个置信度只反映概率分布有多集中,不代表这个判断在工作流里一定正确,更不是执行的许可。
什么情况下值得用
一个简单的判断方法。你要的是一段话,用大模型。你要的是一个能排序、能比较的数,用 Jev。你要用同一个标准重复判断几万次,用 Jev,因为它的一致性和边际成本都不是大模型能比的。
按这个标准,我们手上四个场景的排序是清楚的。
对话上下文压缩最值钱,因为钱就在这里。我统计了自己全部会话的成本,总共 9.13 美元,其中一个长会话占 7.33 美元,八成。那个会话累积了 208 万 token,其中工具输出占 69.2%。缓存读取量是新鲜输入的 89 倍,因为上下文在每一次调用里都要重新走一遍。
但这个场景我还没验证到底。我用「标识符是否在后续消息里再次出现」当标准去检查丢弃是否安全,100 条样本里找不到一个高复用的正例,Jev 分数与实际复用率的相关性只有 0.245。钱这一层验证过了,质量那一层还是开的。上面那个「降级开关」给了修正方向,但还没上机跑。
论文雷达的预筛风险最低。它每天跑,现在的实现靠关键词规则,换成语义判断是升级,判错的代价也只是漏掉一篇。
发布前的引用核验对口我们自己的内容纪律。官方那篇 cookbook 的做法值得抄:先用字符串匹配查引文在不在原文里,这一步不花模型钱;再用一个 Choice 读引文所在的上下文,判断它支持、矛盾还是毫不相关。他们拿 8 条引用做测试,4 条植入的错误全部抓到,其中一条引文逐字出现在原文里,但同一节写着相反的话,判定置信度 0.99。
技能选型这件事,官方已经用我们的技能库验证过了,不需要我们再证明什么。
写在最后
刚拿到 key 的时候,我准备写的是一篇「快 200 倍、便宜 400 倍」的体验稿。跑完之后,那组数字成了文章里最不重要的一段。
真正值得记下来的是另外三件事。便宜 400 倍在便宜的下游面前会缩水到 1.8 倍。同一个任务交给大模型打分,它会给你 75% 的满分。而厂商自己的 cookbook 里,实验样本用的是我们正在用的这套框架。
最后一件是身位。这篇文章里凡是出错的地方,我都写了是哪一步错的、错到什么程度。5 组样本下的中文结论;复合判据导致的全体丢弃;把官方推荐做法误当成自己的发现。转述厂商数字的文章不需要交代这些,因为它们没有跑过。
参考资料
本文所有标注为「官方基准」的数字,均来自下列页面。
官方文档
Cookbook
- 重排序 用概率本身排序,不用阈值
- RAG 段落筛选 含提示注入的剔除
- 结构化抽取与核验级联 附录含「什么才是好的验证器信号」
- 按置信度分类 90% 与 40% 那组数字的出处
- 引用核验
- 重复性实验(Noul) 标准差 0.0102 的出处
- 重复性实验(Choice)
- 批量提问 13 个问题合成一次调用
- 技能建议 Hermes 182 个技能那组实验的出处
- 候选值选择 只让模型在已有候选里挑
- 日期抽取 模型读部件,代码算日历
- 层级分类
- 护栏
- 结构恢复
- 函数调用式参数填充
- 实体对齐
- 语义查找
- 特征发现
本文引用的论文
12 篇摘要的完整标题与链接见前文「图里那 12 篇是什么」的表格。
以上内容基于公开信息与本机实测整理,仅供学习参考。文中实测数据来自作者自有环境,不同任务与配置下的结果可能有差异。
 微信扫码 · 微信支付
 支付宝扫码
本文采用 CC BY 4.0 许可。欢迎转载与引用,请注明作者并附上原文链接。
Licensed under CC BY 4.0. Quoting and republishing are welcome with attribution and a link back to this article.